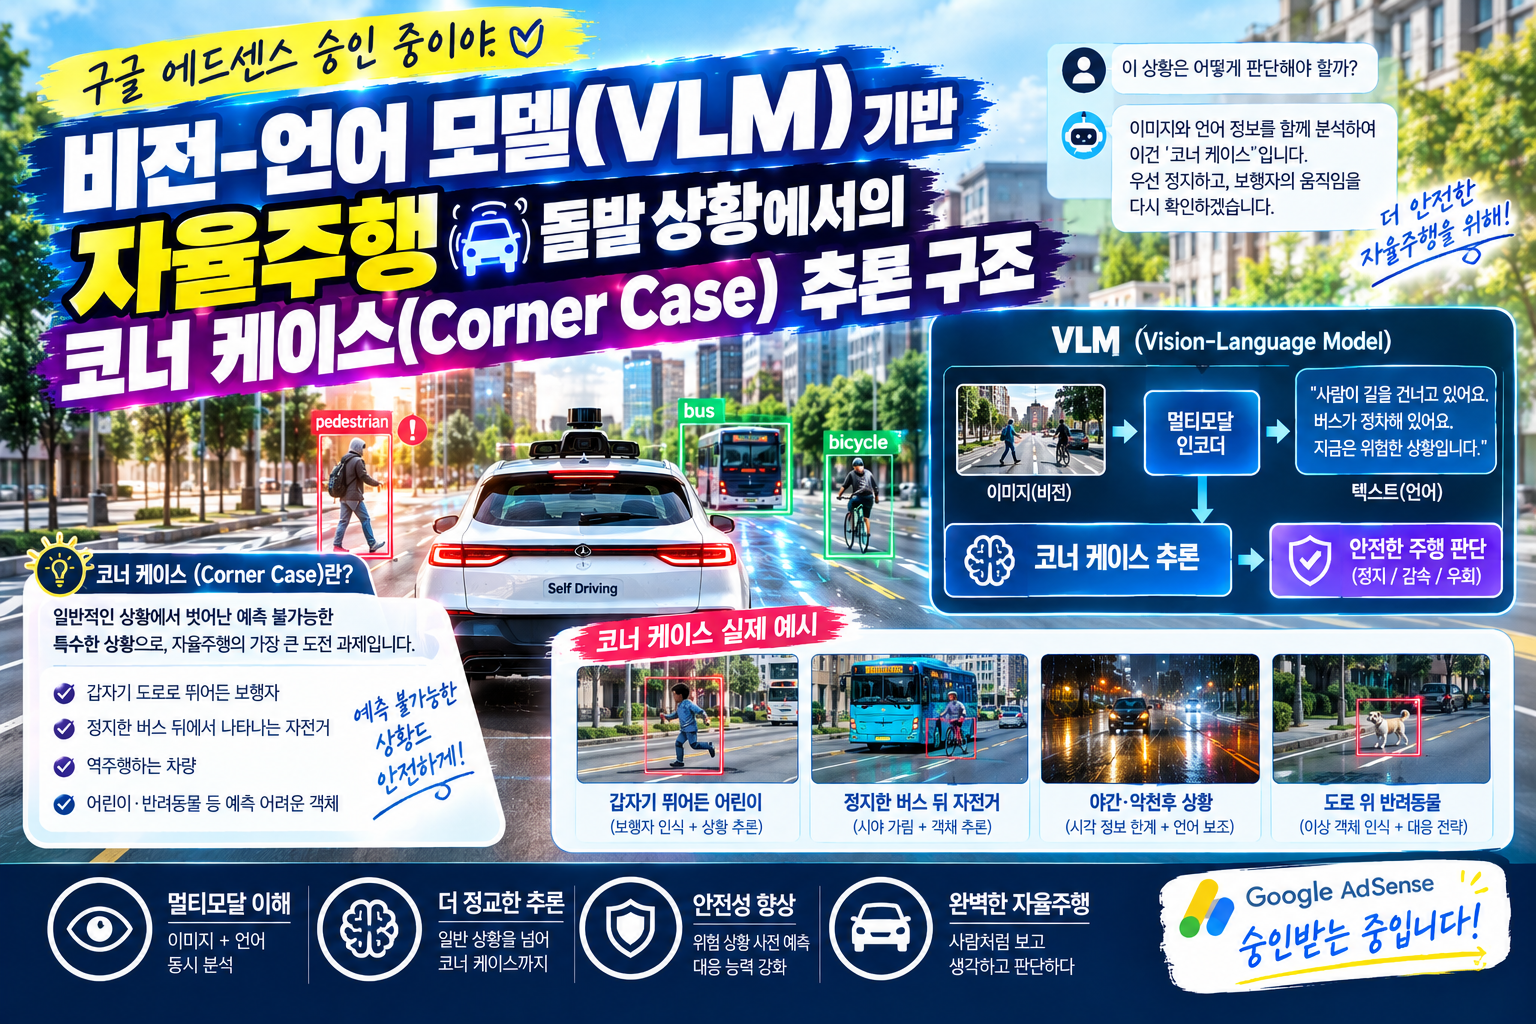
1. 서론: 기존 인지 모델의 한계와 롱테일 코너 케이스(Corner Case)
기존의 자율주행 시스템은 심층 신경망(CNN)이나 트랜스포머(Transformer) 기반의 3D 객체 인식(Object Detection) 및 세그멘테이션(Segmentation) 알고리즘에 의존해 왔습니다. 이러한 시스템은 바운딩 박스(Bounding Box)를 통해 도로 위의 차량, 보행자, 신호등, 신호표지판을 빠르게 식별하는 데 매우 뛰어난 성능을 발휘합니다.
그러나 실제 도로 환경에서는 기존 라벨링 데이터셋으로 학습시키지 못한 무수한 예외 상황, 즉 롱테일 코너 케이스(Long-tail Corner Case)가 발생합니다.
- 사례 1: 트럭 짐칸에 고화질로 인쇄된 실제 차량 사진이나 트래픽 콘 그림.
- 사례 2: 도로 중앙에 떨어진 특이한 형태의 구조물이나 동물 모양의 대형 풍선.
- 사례 3: 경찰관이 수신호로 일시 정지 명령을 내리거나 기존 신호등과 모순되는 지시를 하는 상황.
기존의 룰 기반(Rule-based) 및 지도학습 기반 모델은 상식(Common Sense)과 문맥적 이해 능력이 부족하여 이러한 낯선 객체를 ‘단순 장애물’로 잘못 오인하거나 인식 자체를 실패함으로써 대형 사고로 이어질 수 있습니다. 이 문제를 해결하기 위해 시각 정보와 언어적 상식 추론을 결합한 비전-언어 모델(Vision-Language Model, VLM)이 자율주행 차세대 차세대 인지·판단 프레임워크로 급부상하고 있습니다.
2. VLM 기반 자율주행의 3단계 추론 아키텍처
VLM은 멀티모달(Multi-modal) 데이터 처리 기술을 활용해 이미지·비디오 프레임을 영문/한글 텍스트 개념 공간과 매핑하고, 다단계 논리적 추론 과정을 거쳐 안전한 주행 경로를 도출합니다.
[다중 카메라 프레임] ➔ [Vision Encoder (ViT)] ➔ [Vision-Language Alignment] ➔ [LLM Reasoning Engine] ➔ [Action Token/Trajectory Generation]
2.1 시각적 패치 임베딩(Vision Encoder)
차량 주변의 360도 카메라 이미지 서라운드 뷰는 비전 트랜스포머(Vision Transformer, ViT)를 통해 고차원 임베딩 공간으로 인코딩됩니다.
이미지는 $N$개의 임베딩 패치(Patch)로 분할되며, 각 패치는 공간적 포지셔닝 정보(Positional Embedding)와 결합하여 시각적 피처 벡터 $V \in \mathbb{R}^{N \times D}$로 변환됩니다.
2.2 비전-언어 공간 교차 상호작용 (Alignment Layer)
시각 피처 $V$는 프로젝션 레이어(Cross-Attention Projection Layer)를 통과하여 대규모 언어 모델(LLM)이 이해할 수 있는 토큰 차원 $L$로 투영됩니다.
$$T_v = W_p \cdot V + b_p$$
이 과정을 통해 “도로 위에 쓰러진 나무”나 “누워있는 보행자”와 같은 시각적 토큰이 언어 모델의 사전 학습된 지식 베이스(World Knowledge)와 상호 연관을 맺게 됩니다.
2.3 LLM 기반 상황 추론 엔진 (Reasoning Engine)
임베딩된 시각 토큰 $T_v$와 함께 “현재 차량 속도 60km/h, 차선 변경 가능 여부 판단 요망”과 같은 프롬프트(Prompt) 토큰 $T_q$가 디코더 전용 LLM에 입력됩니다.
LLM은 단순 분류를 넘어 다음 4단계 Chain-of-Thought(CoT) 사고 과정을 수행합니다.
- Description (상황 기술): “전방 15m 지점에 도로 공사용 안내판과 사람이 수신호를 보내고 있음.”
- Explanation (원인 분석): “기존 차선이 막혀 있으며, 수신호는 좌측 차선으로의 우회를 지시하고 있음.”
- Prediction (위험 예측): “직진을 유지할 경우 공사 구조물과 충돌 위험 존재.”
- Action Planning (행동 계획): “속도를 20km/h로 감속하고 좌측 방향지시등을 점등하며 차선 변경 수행.”
3. 코너 케이스(Corner Case) 해결을 위한 핵심 메커니즘
3.1 상식 기반의 제로샷(Zero-Shot) 및 퓨샷(Few-Shot) 대응
VLM의 가장 큰 강점은 학습 데이터셋에 전혀 포함되지 않았던 초유의 객체나 정황에 대해서도 상식적 추론이 가능하다는 점입니다. 인터넷 상의 대규모 멀티모달 데이터로 사전 학습되었기 때문에, “공룡 탈을 쓴 보행자”가 도로에 뛰어들더라도 이를 ‘움직이는 유기체’ 및 ‘보행자’의 범주로 상위 추론하여 즉시 서행 명령을 내릴 수 있습니다.
3.2 환각(Hallucination) 현상 방지 및 Grounding 기법
자율주행에서 LLM의 치명적인 단점은 존재하지 않는 위험을 만들어내거나 실제 있는 장애물을 무시하는 ‘환각 현상’입니다. 이를 방지하기 위해 VLM 아키텍처는 Visual Grounding(시각적 근거 제시) 기법을 내장합니다.
- LLM이 텍스트 형태의 제어 명령을 생성할 때, 해당 명령의 근거가 되는 이미지 상의 픽셀 영역 $B_{box} = [x_{min}, y_{min}, x_{max}, y_{max}]$을 동시 출력하도록 보정합니다.
- 생성된 Bounding Box 영역이 3D LiDAR 포인트 클라우드의 실거리 측정값과 매핑되지 않을 경우, 해당 텍스트 추론을 즉시 기각하는 검증 레이어가 동작합니다.
4. 제어 신호 변환 및 온디바이스 실시간 연산 최적화
VLM의 추론 결과는 문장 텍스트 형태이므로, 이를 차량 제어 시스템(CAN Bus)이 이해할 수 있는 웨이포인트(Waypoint, $X, Y$ 좌표계) 및 속도/조향각 제어 토큰으로 변환해야 합니다.
4.1 궤적 토큰화(Trajectory Tokenization)
최신 VLM 모델(예: DriveLM, LLaVA-Drive)은 언어 모델의 어휘집(Vocabulary)에 숫자로 구성된 3D 웨이포인트 토큰 $[X_1, Y_1], [X_2, Y_2], \dots, [X_k, Y_k]$을 직접 정의합니다. 추론 디코더가 연속된 좌표 토큰을 직접 생성함으로써 일반적인 텍스트 생성과 동일한 파이프라인으로 제어 궤적을 도출합니다.
4.2 초저지연을 위한 경량화 및 온디바이스 최적화
100억 개(10B) 이상의 파라미터를 가진 대형 VLM을 차량용 에지 컴퓨팅 NPU에서 실시간(10Hz 이상)으로 구동하기 위해서는 고도화된 모델 최적화가 필수적입니다.
- W4A16/INT8 양자화(Quantization): LLM 가중치를 4비트 또는 8비트로 압축하여 메모리 대역폭 병목을 완화합니다.
- Speculative Decoding (추측적 디코딩): 소형 경량 SLM(Small Language Model)이 제어 토큰을 초고속으로 먼저 생성하고, 대형 VLM이 주기적으로 결과를 검증·수정하는 하이브리드 파이프라인을 구축합니다.
5. 결론: 인간 수준의 판단력을 지닌 완전자율주행으로의 도약
비전-언어 모델(VLM) 기반의 자율주행 인지·판단 아키텍처는 정형화된 규칙 기반 시스템이 가졌던 롱테일 코너 케이스의 한계를 극복하는 정답지가 되어주고 있습니다. 시각적 상황 파악과 언어적 상식 추론의 융합은 자율주행차가 비상 상황에서도 사람 운전자처럼 현명하고 부드럽게 대처하도록 만듭니다.
앞으로 온디바이스 NPU의 연산 성능 향상과 VLM 경량화 알고리즘의 발전에 힘입어, VLM은 단순 보조 인지 단계를 넘어 자율주행의 핵심 제어 판단 엔진으로 완벽히 정착할 것입니다.
Sima, C., et al. “DriveLM: Driving with Graph Visual Question Answering.” CVPR 2024.
Wen, L., et al. “DiLLaCO: Dilated Vision-Language Co-Processing for Autonomous Driving.” IEEE T-PAMI 2025.