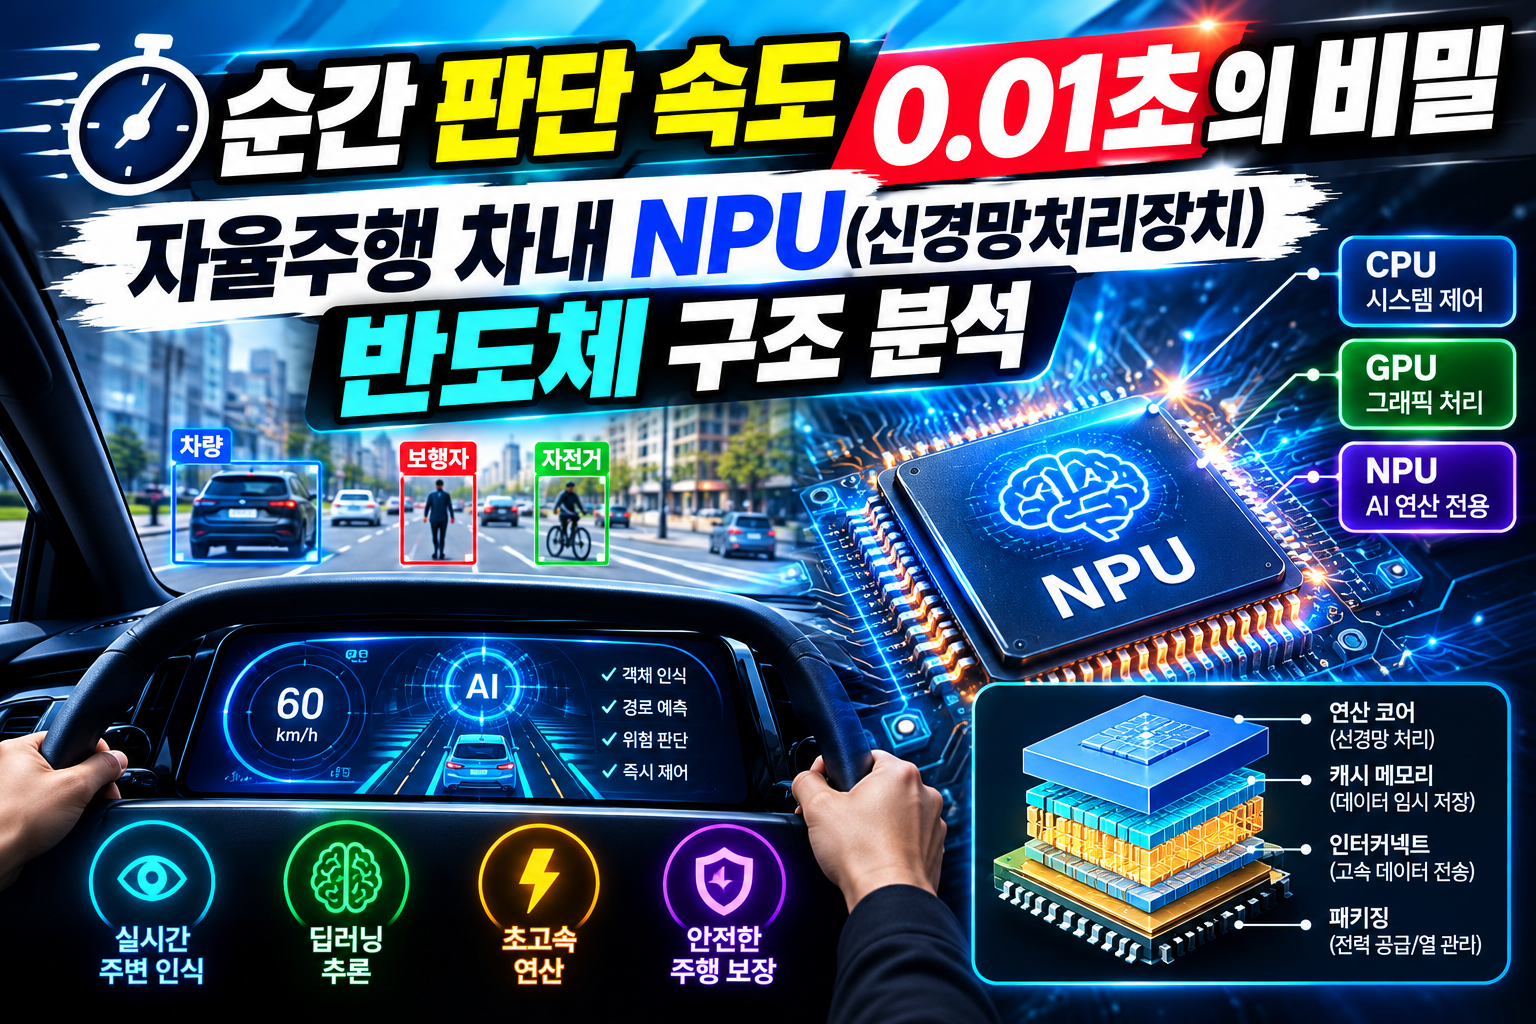
시속 100km/h로 달리는 고속도로 위에서 자율주행 차가 돌발 상황을 감지하고 제동 명령을 내리기까지 주어진 시간은 채 0.1초도 되지 않습니다. 약 0.01초(10ms)라는 짧은 순간 동안 차량에 탑재된 센서는 수 Gigabyte(GB) 크기의 고화질 영상과 3D 라이다 포인트를 쏟아냅니다.
기존의 범용 컴퓨터 중앙처리장치(CPU)나 그래픽처리장치(GPU)는 엄청난 전력 소비와 발열, 그리고 통신 병목 현상으로 인해 이 거대한 데이터를 인공지능(AI) 모델로 즉시 처리하는 데 한계가 있습니다.
이를 해결하고 자율주행의 ‘초저지연(Ultra-Low Latency) 판단’을 가능하게 만드는 핵심 동력이 바로 자율주행 전용 NPU(Neural Processing Unit, 신경망처리장치)입니다. 본문에서는 자율주행 NPU의 아키텍처 구조와 구동 원리를 기술적 관점에서 상세히 분석합니다.
1. NPU란 무엇인가? (CPU / GPU와의 구조적 비교)
NPU는 인간 뇌의 신경망 구조(Synapse와 Neuron)를 칩 형태로 모방하여 행렬 연산(Matrix Multiplication)과 딥러닝 추론(Inference)에 극도로 최적화된 주문형 반도체(ASIC)입니다.
| 구분 | CPU (Central Processing Unit) | GPU (Graphics Processing Unit) | NPU (Neural Processing Unit) |
| 핵심 구조 | 소수의 고성능 코어 (직렬 처리) | 수천 개의 단순 코어 (병렬 처리) | 신경망 연산 전용 MAC 아레이 묶음 |
| 주요 역할 | 복잡한 제어 및 연속적인 명령어 처리 | 그래픽 렌더링 및 대규모 데이터 학습 | 인공지능 딥러닝 알고리즘 추론 전용 |
| 전력 대비 성능 | 낮은 효율 (전력 소비 높음) | 중간 효율 (높은 전력소모 및 발열) | 최고 효율 (Low Power, High TOPS) |
| 자율주행 적용 | 판단 결과에 따른 센서 제어 / OS 관리 | AI 모델 학습 및 가상 시뮬레이션 | 실시간 엣지(On-Device) AI 센서 퓨전 |
2. 자율주행 NPU의 핵심 내부 아키텍처 기술 분석
자율주행차가 순간 속도 0.01초 내에 장애물을 인지하고 경로를 재계산하기 위해 NPU 내부에는 특수한 공학적 설계가 들어가 있습니다.
[센서 데이터 입력 (카메라/라이다)]
               ↓
[SRAM 온칩 메모리 (메모리 병목 해소)]
               ↓
[MAC Array (Systolic Array 기술을 통한 고속 행렬 연산)]
               ↓
[AI 모델 추론 (경로 계획 및 위험 판단 완료 - 0.01초 이내)]
① MAC(Multiply-Accumulate) 아레이와 수시스톨릭(Systolic) 구조
딥러닝의 핵심은 곱셈과 누적 가산을 반복하는 행렬 연산입니다. NPU 내부에는 수만 개의 MAC(곱셈-누적 연산기) 회로가 격자 형태로 배열되어 있습니다.
특히 Systolic Array 구조를 채택하여, 메모리에서 매번 데이터를 가져오는 대신 연산 장치끼리 데이터를 물 흐르듯 직류(Streaming)로 주고받음으로써 데이터 전송 지연 시간을 수만 배 단축시킵니다.
② 메모리 벽(Memory Wall)을 깨는 SRAM 온칩 설계
기존 컴퓨터는 연산 장치와 DRAM(외부 메모리) 사이의 통신 병목 현상(폰 노이만 병목) 때문에 지연이 발생합니다. 자율주행 NPU는 초고속 SRAM(Static RAM)을 반도체 다이 내부(On-Chip)에 대용량으로 배치합니다. 메모리와 연산 유닛 간의 거리를 없앰으로써 전력 소비를 80% 이상 절감하고 데이터 처리 속도를 극대화합니다.
③ 양자화(Quantization) 및 가속 알고리즘 Engine
센서 데이터를 처리할 때 Floating Point 32(FP32, 32비트 실수) 연산을 8비트 정수(INT8)로 변환하는 양자화 기술이 적용됩니다. 정밀도 손실은 1% 미만으로 줄이면서 연산량과 데이터 크기는 1/4 수준으로 압축하여 0.01초 이하의 신속한 추론을 가능케 합니다.
3. 온디바이스(On-Device) AI 기반 엣지 컴퓨팅의 중요성
자율주행차의 NPU는 클라우드 서버와 통신하지 않고 차 안에서 스스로 계산을 완료하는 온디바이스(On-Device) 엣지 컴퓨팅 방식으로 작동합니다.
- 네트워크 지연(Latency) 통제: 5G/6G 통신망이 순간적으로 끊기거나 음영 지역에 진입하더라도 차량 자체 NPU에서 모든 판단이 완료되므로 끊김 없는 안전 주행이 보장됩니다.
- 센서 퓨전(Sensor Fusion) 데이터 처리: 8K 카메라 영상 8개 채널, 라이다 점군 데이터, 레이더 전파 신호가 동시에 NPU로 유입되면, 실시간으로 통합 레이어로 시냅스 연산을 수행하여 3D 공간을 복원합니다.
4. 자율주행 반도체의 미래: 차세대 NPU 발전 방향
세계 주요 빅테크 기업과 완성차 제조사들은 테슬라의 FSD HW4/HW5 칩, 앤비디아의 드라이브 토르(Drive Thor)와 같이 독자적인 NPU 아키텍처 개발 경쟁을 벌이고 있습니다.
미래 자율주행 NPU는 단순한 신경망 연산을 넘어, 연산 장치와 메모리를 완전히 하나로 통합한 PIM(Processing-In-Memory) 기술 및 가변형 구조의 FPGA/SNN(스파이킹 신경망) 아키텍처로 진화하고 있습니다.
결과적으로 자율주행 차내 NPU의 초저지연 연산 능력은 사고율 ‘0%’에 도전하는 미래 모빌리티 상용화의 가장 핵심적인 하드웨어적 백본(Backbone)이 될 것입니다.