1. 서론: 왜 자율주행은 탑뷰(Bird’s-Eye-View) 공간을 필요로 하는가?
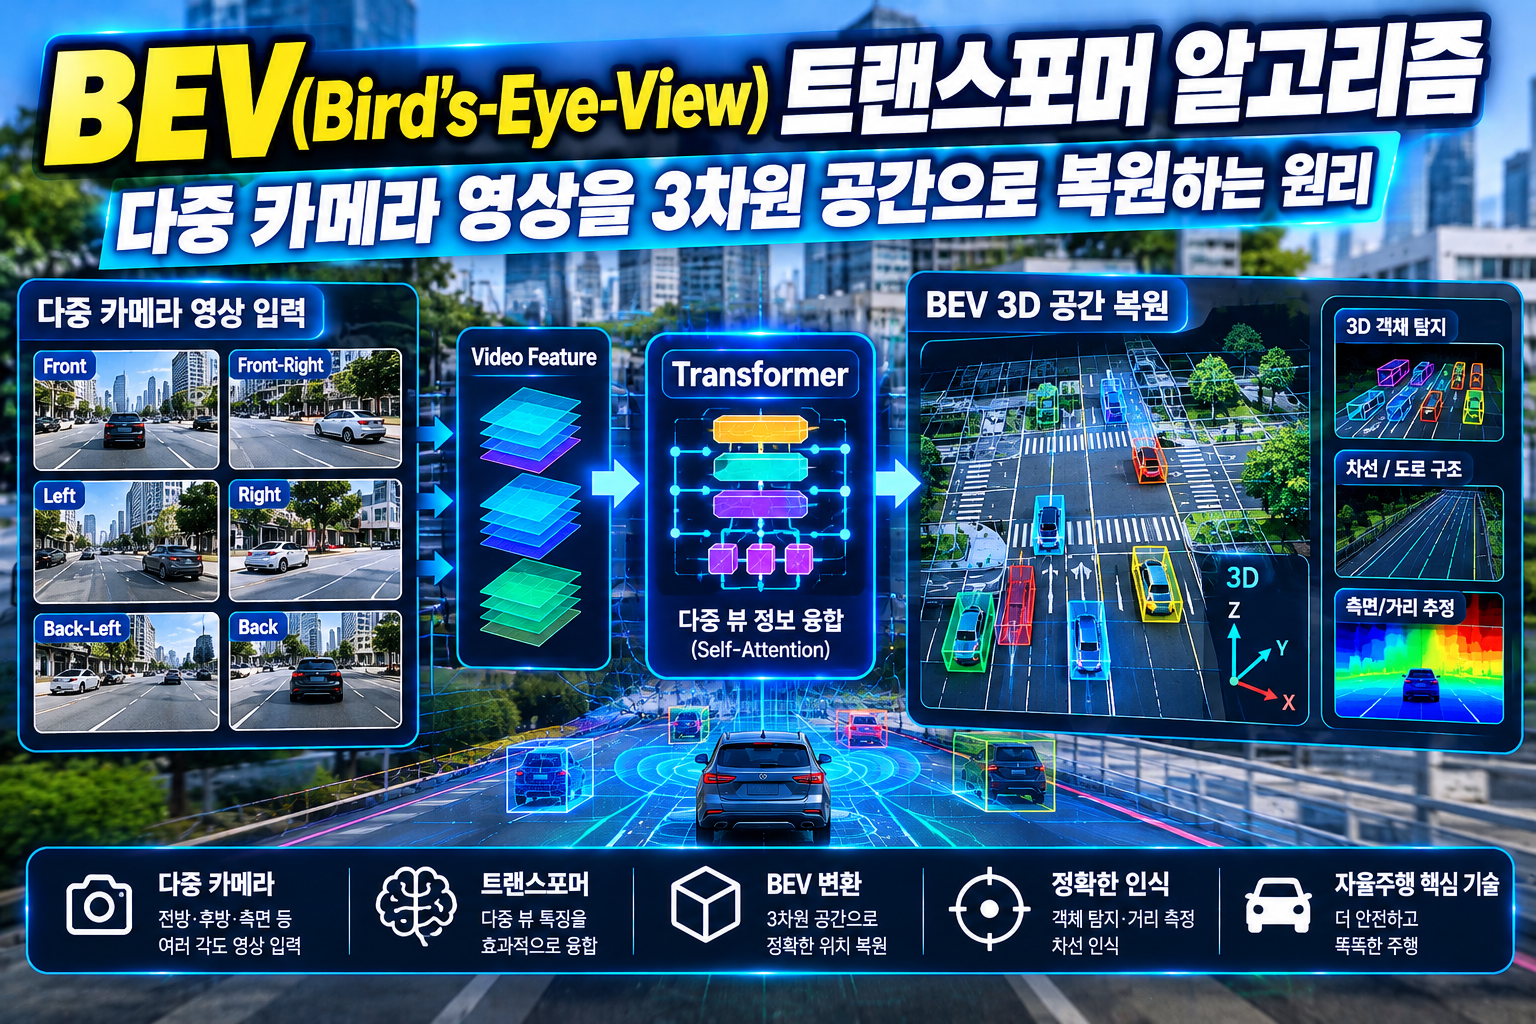
자율주행 차량에는 전방, 후방, 측방을 아우르는 수많은 서라운드 뷰(Surround-view) 카메라가 탑재되어 있습니다. 기존의 딥러닝 기반 2D 컴퓨터 비전 기술은 각 카메라가 촬영한 이미지 패치(Image Domain) 내에서 차량, 보행자, 차선 등의 바운딩 박스를 개별적으로 추정해 왔습니다.
그러나 이미지 좌표계(Perspective View)에서 수행되는 2D 인식 결과는 자율주행의 경로 계획(Path Planning) 및 제어(Control) 단계에 직접 활용하기 어렵다는 치명적인 한계가 있습니다.
- 스케일 왜곡과 원근감: 카메라에서 멀어질수록 동일한 크기의 물체가 이미지상에서는 매우 작은 피셀로 축소됩니다.
- 카메라 간 중첩 영역 처리 문제: 여러 카메라의 경계선(Overlap Region)에 걸쳐 있는 물체는 이중으로 감지되거나 위치 추정에 오차가 발생합니다.
- 높이 정보 부족: 2D 픽셀 좌표만으로는 실제 3차원 공간상의 x, y, z 거리(Depth)를 직관적으로 산출할 수 없습니다.
이러한 문제를 해결하기 위해 등장한 개념이 바로 BEV(Bird’s-Eye-View) 공간 표현 체계입니다. 하늘에서 수직으로 내려다보는 고정 3차원 평면 좌표계 상에 모든 카메라 신호를 통합함으로써, 물체의 폐색(Occlusion) 문제를 완화하고 차선 지도(Vector Map) 및 동적 장애물의 위치를 왜곡 없이 복원할 수 있습니다.
2. 2D에서 3D 공간으로의 변환: 기하학적 한계와 깊이(Depth) 불확실성
2D 이미지를 3D BEV 공간으로 매핑하는 과정은 수학적으로 역투영(Unprojection) 문제에 해당합니다. 핀홀 카메라 모델(Pinhole Camera Model)에 따라 3차원 공간 상의 점 $P(X, Y, Z)$는 다음의 투영 행렬을 통해 2D 픽셀 $p(u, v)$로 매핑됩니다.
$$p = K \cdot [R \mid t] \cdot P$$
여기서 $K$는 카메라 내부 파라미터(Intrinsic Matrix), $[R \mid t]$는 카메라의 외부 파라미터(Extrinsic Matrix)입니다.
이 투영 과정에서 높이 또는 깊이 정보($Z$)가 2D 평면으로 압축되기 때문에, 반대로 2D 픽셀 하나를 3D 공간으로 복원할 때는 하나의 픽셀이 3D 공간 상에서 하나의 무한한 광선(Ray)으로 확장됩니다. 즉, 해당 픽셀에 위치한 물체가 카메라로부터 몇 미터 떨어져 있는지 알 수 없는 일대다(1-to-Many) 모호성이 발생합니다.
BEV 알고리즘의 핵심 과제는 바로 이 “각 픽셀의 깊이(Depth)를 얼마나 정확하게 예측하여 3D 공간에 올바르게 배치할 것인가”에 있습니다.
3. 대표적인 BEV 패러다임: LSS(Lift-Splat-Shoot)부터 트랜스포머 기반 접근까지
BEV 공간을 생성하는 대표적인 접근법은 크게 명시적 기하학 변환(Explicit Geometric Approach)과 트랜스포머 기반 암시적 학습(Implicit Transformer Approach)으로 나뉩니다.
3.1 LSS (Lift-Splat-Shoot) 패러다임
Philion 등이 제안한 LSS 기술은 CNN 기반 BEV 변환의 기초를 정립했습니다.
- Lift (인상): 2D 이미지 특징 맵(Feature Map)의 각 픽셀에 대해 이산화된 깊이 범주(Categorical Depth Distribution)를 확률적으로 예측합니다. 2D 특징 벡터와 깊이 확률 분포를 외적(Outer Product)하여 3D 프러 스텀(Frustum) 자원을 형성합니다.
- Splat (투척): 카메라 외부 파라미터를 사용하여 생성된 3D 프러스텀 특징들을 하나의 공통된 BEV 격자(Grid) 공간으로 좌표 변환합니다. 이때 발생되는 3D 포인트 클라우드 형태의 데이터는 Voxel Pooling 기법을 통해 BEV 평면상으로 합쳐집니다.
- Shoot (사격): 최종 매핑된 BEV 특징 맵을 바탕으로 2D CNN 헤드를 적용하여 3D Bounding Box 감지 및 맵 세그멘테이션을 수행합니다.
LSS 방식은 기하학적 연산이 직관적이라는 장점이 있으나, 정확한 Depth 범주 예측에 극도로 의존하며, 깊이가 틀릴 경우 BEV 좌표 전체가 뒤틀리는 취약점이 존재합니다.
4. BEV 트랜스포머(BEV Transformer)의 핵심 동작 원리
LSS의 Depth 추정 한계를 극복하기 위해 등장한 것이 바로 트랜스포머(Transformer)의 Cross-Attention 메커니즘을 활용한 방식입니다. 가장 대표적인 BEVFormer 구조를 바탕으로 그 원리를 분석합니다.
[다중 2D 카메라 이미지] ➔ [Backbone (ResNet/Swin)] ➔ [Spatial Cross-Attention] ➔ [Temporal Self-Attention] ➔ [BEV Feature Grid]
4.1 BEV 쿼리(BEV Query) 중심의 역방향 매핑
기존 방식이 “2D 이미지를 3D로 뿌려주는(Bottom-Up)” 방식이었다면, BEV 트랜스포머는 “3D BEV 공간상의 쿼리가 필요한 2D 이미지 정보를 끌어오는(Top-Down)” 접근을 사용합니다.
- BEV Grid 정의: 차량 중심을 기준으로 일정 공간(예: $X \in [-50m, 50m], Y \in [-50m, 50m]$)을 정밀한 격자(Grid) 단위로 분할하고, 각 격자점에 학습 가능한 BEV Query ($Q_{bev}$)를 할당합니다.
- 3D Anchor Point 생성: 각 BEV Query 위치에 대해 물리적인 높이 영역(Z축 방향)을 고려하여 복수의 3D 앵커 포인트를 정의합니다.
- 카메라 투영 매핑: 정의된 3D 앵커 포인트들을 카메라 Extrinsic/Intrinsic 행렬을 통해 연관된 여러 대의 2D 카메라 이미지 평면 상의 픽셀 좌표로 역투영합니다.
4.2 공간적 교차 주의집중 (Spatial Cross-Attention)
역투영된 2D 픽셀 위치를 중심으로, BEV Query는 실제로 연관된 카메라의 2D 이미지 특징 맵(Feature Map)에서 원하는 유의미한 정보만을 선택적으로 획득(Attention)합니다.
- Deformable Attention 기법을 적용하여 2D 이미지 전체를 검색하는 대신 투영된 변형 위치 주변의 K개 샘플링 포인트만을 참조함으로써 연산 효율성을 극대화합니다.
- 이를 통해 별도의 명시적인 Depth Estimation 단계 없이도 신경망이 다중 카메라 뷰 간의 컨텍스트를 학습하여 3D 공간 특징을 유연하게 수집할 수 있습니다.
4.3 시간적 자가 주의집중 (Temporal Self-Attention)
자율주행에서는 정지된 단일 프레임 정보뿐만 아니라 시간의 흐름에 따른 동적 변화 추적이 필수적입니다.
- BEV 트랜스포머는 이전 타임스텝($t-1$)의 BEV 특징 맵을 ego-motion(자차 이동 정보)을 기반으로 현재 타임스텝($t$) 위치로 좌표 정렬(Warping)합니다.
- 현재 프레임의 BEV Query와 이전 프레임의 BEV 특징 간에 Temporal Self-Attention을 수행함으로써, 폐색(Occlusion)된 물체의 위치 추정이나 동적 장애물의 속도/가속도 추정 성능을 획기적으로 향상시킵니다.
5. 실무 구현 시의 핵심 도전 과제 및 해결 전략
- 카메라 캘리브레이션 오차(Extrinsic Calibration Error):차량 주행 중 진동이나 온도로 인해 카메라 위치가 미세하게 변하면 투영 행렬이 어긋나 BEV 쿼리가 잘못된 2D 픽셀을 참조하게 됩니다. ➔ 이를 해결하기 위해 최신 모델은 Extrinsic 변수를 가변 입력으로 받아 트랜스포머 오프셋을 자동 보정하는 Calibration-Aware Attention을 도입합니다.
- 고해상도 온디바이스 연산 병목 (Computational Complexity):BEV Grid의 해상도(Resolution)를 높일수록 Query 개수가 기하급수적으로 증가하여 GPU 메모리 소모가 극심해집니다. ➔ Sparse Query 방식(예: PETR 시리즈)이나 TensorRT를 활용한 쿼리 가지치기(Pruning) 및 FP16/INT8 양산화(Quantization) 작업이 병행됩니다.
- 악천후 및 센서 페일세이프(Fail-Safe):특정 카메라에 렌즈 오염이나 유실이 발생할 경우 BEV 전체가 무너질 수 있습니다. ➔ 라이다(LiDAR) 및 4D 이미징 레이더 포인트 클라우드를 BEV 트랜스포머 입출력단에 결합하는 Multi-Modal Sensor Fusion 구조로 발전하고 있습니다.
6. 결론: BEV 트랜스포머가 이끄는 자율주행의 미래
BEV 트랜스포머 기술은 2D 시각 정보와 3D 물리 공간 사이의 간극을 뛰어넘은 혁신적인 컴퓨터 비전 패러다임입니다. 이 기술은 단순한 3D Object Detection에 그치지 않고, 도로 구조 파악(Occupancy Grid Network) 및 End-to-End 자율주행(인식-예측-제어를 단일 트랜스포머로 처리) 모델의 핵심 프레임워크로 발전하고 있습니다.
다중 센서의 기하학적 정렬 능력과 시간축 통합 능력을 극대화한 BEV 트랜스포머는 향후 레벨 3 이상의 도심 자율주행 상용화를 이끄는 핵심 인공지능 알고리즘으로 자리매김할 것입니다.
참고 문헌 및 기술 논문 출처 추가:
- Li, Z., et al. “BEVFormer: Learning Bird’s-Eye-View Representation from Multi-Camera Images via Spatiotemporal Transformers.” ECCV 2022.
- Philion, J., & Patel, N. “Lift, Splat, Shoot: Encoding Images from Arbitrary Cameras for 3D Bird’s-Eye-View Motion Planning.” ECCV 2020.