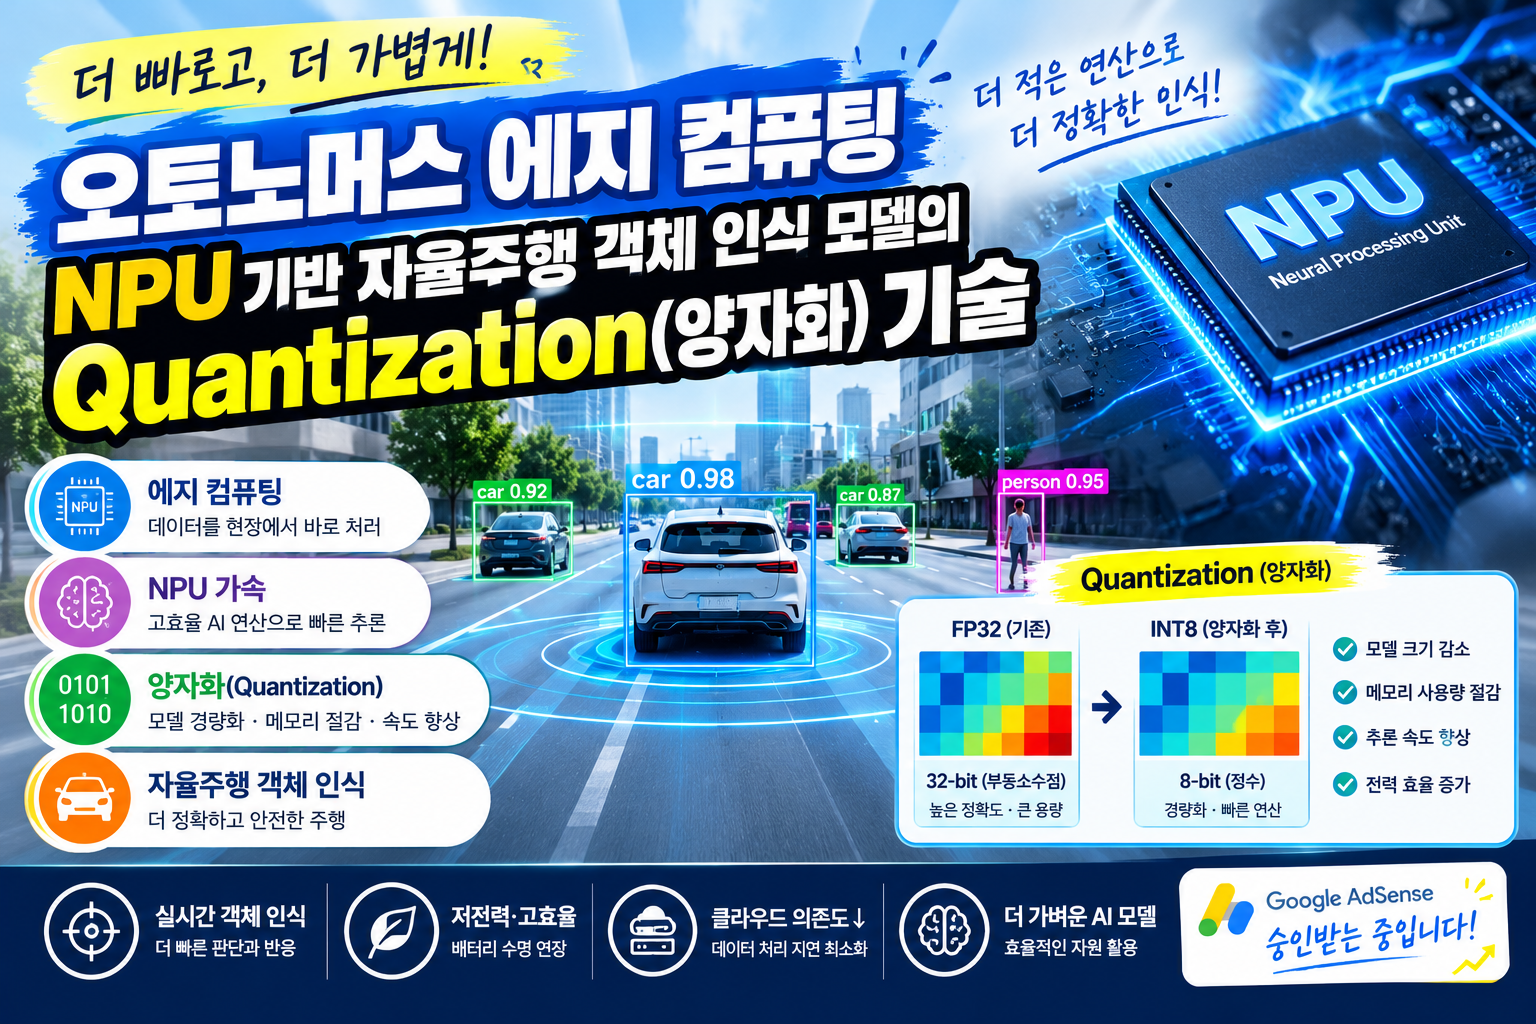
1. 서론: 왜 자율주행 에지 컴퓨팅에서 양자화(Quantization)인가?
레벨 3 이상의 고도화된 자율주행 차량은 수십 개의 고해상도 카메라, 라이다(LiDAR), 레이다(Radar) 센서로부터 초당 수십 기가바이트(GB)에 달하는 대용량 실시간 데이터를 수집합니다. 이를 처리하기 위한 딥러닝 기반 3D 객체 인식 및 세그멘테이션 모델은 수억 개 이상의 파라미터를 보유하고 있어, 극심한 연산 자원을 요구합니다.
그러나 자율주행 환경은 중앙 서버가 아닌 차량 내부의 제한된 전력과 열 설계 전력(TDP) 내에서 구동되는 에지 컴퓨팅(Edge Computing) 환경입니다.
- 하드웨어 제약: 차량용 NPU(Neural Processing Unit)는 고성능 클라우드 GPU에 비해 메모리 대역폭과 SRAM 용량이 한정되어 있습니다.
- 초저지연(Ultra-Low Latency) 요구: 100km/h로 주행하는 차량에서 10ms의 인식 지연은 수 미터의 제어 오차로 이어집니다.
- 전력 소비 및 발열: 고전력 연산은 차량 배터리 소모를 가중시키고 하드웨어 발열로 인한 딥러닝 추론 성능 저하를 유발합니다.
이러한 하드웨어 한계를 극복하고 NPU의 연산 효율성(TOPS/W)을 극대화하기 위해 핵심적으로 적용되는 기술이 바로 딥러닝 모델 양자화(Quantization)입니다.
2. Quantization(양자화)의 수학적 원리 및 데이터 매핑
딥러닝 양자화의 핵심은 모델의 가중치(Weight)와 활성화 함수 출력값(Activation)을 표현하는 연속적인 부동소수점 데이터(예: 32비트 FP32)를 정밀도가 낮지만 연산 속도가 압도적으로 빠른 경량 정수형 데이터(예: 8비트 INT8)로 매핑하는 것입니다.
2.1 아파인 양자화(Affine Quantization) 매핑 공식
부동소수점 값 $x$를 정수값 $q$로 수식 변환하는 선형 양자화(Linear Quantization) 공식은 다음과 같습니다.
$$q = \text{round}\left( \frac{x}{S} \right) + Z$$
- $S$ (Scale Factor): 부동소수점 범위와 정수 범위를 동기화하는 축소 비율입니다.
- $Z$ (Zero-Point): 부동소수점의 $0.0$에 해당하는 정수 오프셋입니다.
실제 부동소수점 값으로 복원(Dequantization)할 때는 다음 공식을 사용합니다.
$$\hat{x} = S \times (q – Z)$$
2.2 대칭 양자화(Symmetric) vs 비대칭 양자화(Asymmetric)
- 대칭 양자화: Zero-Point($Z$)를 $0$으로 고정하고 양수와 음수의 범위를 대칭으로 매핑합니다. 연산 구조가 단순하여 NPU 하드웨어 가속기에서 가장 높은 처리 속도를 발휘합니다.
- 비대칭 양자화: ReLU와 같이 $0$ 이상의 값만 존재하는 활성화 함수 영역에 유용하며, 가용한 정수 비트 범위를 효율적으로 분배할 수 있습니다.
3. 양자화 기법의 두 가지 핵심 패러다임: PTQ vs QAT
NPU 기반 최적화 과정에서 적용되는 양자화 기법은 모델 재학습 여부에 따라 PTQ와 QAT로 나뉩니다.
3.1 PTQ (Post-Training Quantization: 학습 후 양자화)
이미 학습이 완료된 FP32 모델을 가벼운 캘리브레이션(Calibration) 데이터셋만을 활용하여 빠르게 INT8로 변환하는 기법입니다.
- 동작 프로세스:
- 학습 완료된 모델 준비.
- 수백 장 내외의 자율주행 대표 도로 데이터(Calibration Dataset) 투입.
- 각 레이어별 활성화 값의 최소/최대 분포를 수집(Kullback-Leibler Divergence 등을 사용).
- 최적의 Scale Factor $S$와 Zero-Point $Z$를 도출하여 INT8로 변환.
- 장점: 모델 재학습이 필요 없어 몇 분 내로 NPU 변환이 완료됩니다.
- 단점: 복잡한 3D Bounding Box 추정 모델의 경우 정밀도 손실(Accuracy Drop)이 발생할 수 있습니다.
3.2 QAT (Quantization-Aware Training: 양자화 인지 학습)
학습 과정 자체에 양자화 손실 오차를 내장시켜, 가중치가 INT8 변환 환경에 맞추어 보정되도록 복원 학습하는 고도화 기법입니다.
- Fake Quantization 기법: 순전파(Forward Pass) 시에는 Quantization 수식을 적용하여 정수화 오차를 모사하고, 역전파(Backward Pass) 시에는 미분 불가능한 round 함수를 극복하기 위해 STE(Straight-Through Estimator) 기술을 적용하여 미분값을 전파합니다.
- 장점: PTQ 대비 모델의 인식 정확도(mAP) 손실을 $1\%$ 이내로 극적으로 보전합니다.
- 단점: 전체 데이터셋을 통한 재학습이 필요하므로 학습 시간과 컴퓨팅 자원이 추가 소비됩니다.
4. NPU 아키텍처 결합 및 자율주행 실무 응용
NPU 하드웨어 관점에서 INT8 양자화가 가져오는 실질적인 혜택은 다음과 같습니다.
- 메모리 대역폭(Bandwidth) 오버헤드 75% 감소:FP32(4 Bytes)에서 INT8(1 Byte)로 데이터 크기가 감소하므로, NPU 내부 SRAM과 외부 DRAM 간의 데이터 이동 병목 현상이 획기적으로 줄어듭니다.
- MAC(Multiply-Accumulate) 연산 장치 집적도 상승:동일한 칩 면적 내에 FP32 연산기보다 훨씬 작은 INT8 MAC 연산기를 수배 이상 더 많이 배치할 수 있어 연산 처리량(TOPS)이 극대화됩니다.
- 혼합 정밀도(Mixed-Precision) 전략:민감도가 높은 백본(Backbone) 초기 레이어나 3D Detection Head 단은 FP16으로 유지하고, 범용적인 컨볼루션(Convolution) 레이어는 INT8로 변환하는 하이브리드 수렴 전략을 적용하여 정확도와 속도를 동시에 달성합니다.
5. 결론 및 향후 전망
자율주행 온디바이스 에지 컴퓨팅의 핵심 지향점은 “얼마나 최소한의 전력으로 정확하고 신속하게 위험을 감지하는가”에 있습니다. NPU 하드웨어 특성에 맞춘 양자화(Quantization) 기술은 딥러닝 알고리즘의 경량화를 달성하는 가장 강력한 솔루션입니다.
최근에는 FP8, INT4 등 더욱 미세한 정밀도로 도약하는 초경량화 연구와 더불어, 트랜스포머(Transformer) 기반 BEV 모델의 Attention 파이프라인을 효율적으로 양자화하는 기술이 핵심 트렌드로 자리 잡고 있습니다.
acob, B., et al. “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference.” CVPR 2018.
NVIDIA TensorRT Quantization Developer Guide.